HiFloat赛事成果解读|Wan2.2双专家模型的少步蒸馏与低比特量化
ICMEWan2.2
视频生成模型正在经历一轮快速的能力跃迁——视觉质量、主体可控性、时序建模都在变强,但代价是参数量、显存占用和推理成本同步飙升。视频生成模型的部署成本,既来自庞大的模型参数,也来自反复执行的去噪计算。压缩权重可以缓解存储压力,减少采样步数可以缩短计算过程,但要同时保住画面细节、主体一致性和运动连贯性,就需要把这两条路线放在一起设计。
2026年5月,由全球计算联盟(GCC)主办的IEEE ICME 2026低位宽大模型量化挑战赛赛程结束。赛事聚焦HiFloat4/HiFloat8等低位宽数值格式,围绕文本生成图像与文本生成视频两大任务,设置W4A4推理量化与W8A8训练量化两条主赛道,吸引了来自全球高校、科研机构与产业界的众多团队参与。
以下是基于W4A4推理量化赛道,针对开源模型Wan2.2-T2V-A14B的创新方案。过少步蒸馏缩短生成轨迹,再结合双专家分别校准、权重按通道量化、激活按 token 量化,以及关键入口层保护,降低低比特表示带来的质量损失。
一、Wan2.2的挑战
相比于Wan2.1,Wan2.2 的结构带来了新挑战。
1.1 两个专家,各司其职
Wan2.2 的去噪轨迹被噪声阶段切成两段:
高噪声专家:负责早期"素描"阶段,强调全局构图、空间关系和粗粒度运动规划;
低噪声专家:负责后期细化阶段,专注光照、纹理、材质细节和帧间一致性。
这种分工让模型质量远超同计算量的稠密模型,但也让量化不能再"一套方案打天下"。
1.2 三个量化难题
相对于上一代 Wan2.1,双专家结构带来了三个本质性困难:
1.推理路径不连续:专家随噪声阶段动态切换,量化阶段不能假设存在一条从头到尾的单一主干,必须显式支持分支级参数捕获和分支专属保护策略。
2.激活分布跨阶段差异巨大:高噪声与低噪声专家看到的输入分布完全不同,时空 token 的数值异质性强,整体动态范围更宽、更不均匀,窄动态范围的量化格式很容易出现溢出或下溢。
3.总权重体积更大:27B 的总体量让模型对量化误差更敏感,同样的比特宽度下,质量退化比稠密骨干更明显。
正因如此,核心命题不是"怎么把模型量化",而是"怎么为这种双分支结构找到一条可行的加速路径"。
二、方案总览
整个 pipeline 遵循端到端流程:
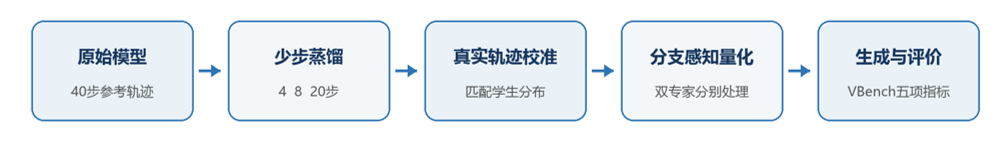
核心思路是从两个维度同时压缩:
纵向压缩:减少采样步数,从 40 步长轨迹缩短到 4 / 8 / 20 步;
横向压缩:降低每一步的计算与存储成本,使用权重 4 位、激活逐 token 的低位量化。
但这项工作最关键的设计,是不让蒸馏和量化各自为战。校准不是一个孤立的静态过程,而是在真实的少步部署设定下进行——量化器看到的激活分布,必须和模型上线后实际遇到的分布一致。
三、少步蒸馏
3.1 DMD 与 Phased DMD
本文采用 DMD(Distribution Matching Distillation,分布匹配蒸馏)及其分阶段版本 Phased DMD。DMD对齐教师模型的整体生成分布。
但对视频扩散模型来说,单一均匀的蒸馏目标仍然不够。因为去噪过程本身是阶段结构化的:
高噪声阶段:建立全局布局、主体位置、运动趋势;
低噪声阶段:纹理恢复、边界细化、局部时序修复。
一个不加区分的目标函数,会忽略不同阶段承载的不同功能。Phased DMD 因此将损失拆成两部分:
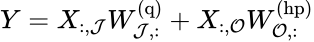
这一设计对视频生成尤为关键。图像合成关注最终静态质量,但视频还必须保证跨帧主体一致、运动平滑、镜头稳定。如果高噪声阶段没能建立连贯的全局结构,后期低噪声阶段再怎么修也补不回结构性错误;反过来,如果低噪声阶段太弱,即使早期结构合理,最终视频也会纹理粗糙、局部抖动。
3.2步数确定
实验比较了4、8、20、40步四种设定,最终选择 20 步作为工程部署配置。
值得注意的是,蒸馏的价值不只是提速。一旦应用 DMD少步蒸馏,模型在更短轨迹下生成的视频,在运动组织和整体稳定性上往往比 40 步教师模型表现更好。这说明少步学生模型不是"砍掉一半步骤的妥协品",而是重新学习了一条更适合视频生成任务的短轨迹——Phased DMD 进一步优化了不同阶段的职责分配。
这一点对后续量化至关重要:一个被蒸馏得更稳定、更"规矩"的学生模型,其激活分布也更适合被低位量化。
四、HiF4量化
4.1 量化方法的选择
在训练后量化(PTQ)方法谱系中,有些依赖重建、学习或二阶校正,理论误差恢复更强,但对视频生成模型来说—长时序、多帧、条件控制复杂—这类方法通常意味着更多超参调试、更长离线处理和更重的工程链路。
因此项目选择了轻量的 rounding-based(舍入式)量化作为基础方案,不引入额外的重建训练阶段,转而通过三个策略提升低比特下的实战表现:
- 细粒度量化配置:逐通道(per-channel)权重量化和逐 token(per-token)激活量化;
- 入口层保护:对少量关键入口层保留更高精度;
- 增强首块校准:强化第一个 block 的校准过程,抑制误差在后续去噪步中的累积。
同时,采用浮点风格的低比特表示来缓解低振幅区域动态范围不足、分辨率不够的问题。
4.2 HiF4数据格式
比赛要求使用 HiF4(HiFloat4)——一种 4 位块浮点(BFP)格式。它的基本存储单元是:
1. 32 位共享缩放元数据 + 64 个块内 4 位元素
- 平均存储成本 = 4.5 bit / 数值
这 32 位元数据编码了一个三级层次化缩放结构:
| 层级 | 格式 | 作用 |
|---|---|---|
| Level 1 | E6M2(6 位指数 + 2 位尾数) | 全局基尺度,动态范围约 69 个二进制数量级(binade) |
| Level 2 | E1_8(8 个微指数位) | 将 64 个元素分为 8 组,做二级细化 |
| Level 3 | E1_16(16 个微指数位) | 将 64 个元素分为 16 组,做三级细化 |
| 元素 | S1P2(符号位 + 1 位整数 + 2 位小数) | 每个数值的实际编码,提供 3 位有效精度 |
与 NVFP4 常用的 E4M3(约 22全局动态范围)和 E2M1(2 位有效精度)相比,HiF4 的优势一目了然:
- 全局范围宽(约 69 binade vs 约 22 binade),可以直接覆盖极端推理值,不需要额外的软件级per-tensor scaling;
- 局部精度更细(S1P2 有 3 位有效精度 vs E2M1 的 2 位);
- 局部动态范围约 4.81 binade,配合 64 元素块仍能高效映射到矩阵乘法。
对于高斯分布数据,三种 4 位 BFP 格式的均方误差比为:
HiF4: NVFP4:MXFP4 = 1 : 1.32 : 1.89
HiF4 量化误差最低。这一特性对 Wan2.2 格外重要——双专家切换导致激活分布跨阶段差异大、时空 token 数值异质性强,窄范围格式很容易在某些阶段溢出、另一些阶段下溢。
4.3 双专家结构的量化适配
针对 Wan2.2 的分支切换:
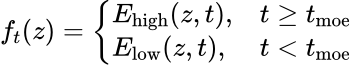
量化阶段不能再假设单一连续主干。项目采用分支级逐层校准与替换策略:
- 分别捕获每个专家第一个 block 的输入;
- 每个分支沿着自己的真实执行路径逐层传播;
- 统计、量化、替换都在该分支的推理路线上完成。
量化变成了两条协调的逐层遍历,而不是对单主干的一次扫描。
五、协同设计
5.1 分布不匹配
蒸馏后学生模型在时间步 t 的激活分布,和原始高步参考模型并不相同:
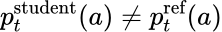
这种差异是学生模型有意学习短轨迹策略的结构性结果。如果量化校准仍然假设高步参考模型的统计量,量化器在训练时看到的分布和部署时遇到的分布就会错位,低比特误差会被进一步放大。
5.2 在学生轨迹上做校准
解决方案:在校准阶段直接使用蒸馏学生模型的激活,而不是原始教师模型的激活。
同时,量化还要尊重阶段差异:
- 高噪声阶段的大误差 → 扰乱全局结构和运动组织;
- 低噪声阶段的大误差 → 纹理退化、细节模糊、帧间抖动。
这种协同设计带来两个直接收益:
- 步数减少直接降低总推理成本:
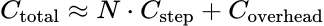 ,N 从 40 降到 20;
- 校准分布对齐让量化模型在低比特部署下更能同时保住全局结构和局部细节。
六、实验结果
6.1 实验设定
- 硬件:双路 Intel Xeon Platinum 8462Y+、2 TB 内存、NVIDIA H100 80GB HBM3(CUDA 12.4);
- 评估指标:VBench 五个核心维度——Subject Consistency(SC,主体一致性)、Aesthetic Quality(AQ,美学质量)、Imaging Quality(IQ,成像质量)、Overall Consistency(OC,整体一致性)、Motion Smoothness(MS,运动平滑度);
- 对比对象:原始全精度模型、同步数全精度蒸馏模型、同步数量化模型;
- 控制变量:采样步数 4/8/20/40、随机种子 42 和 27182。
6.2 早期直接量化
在引入少步蒸馏之前,我们先进行了预实验,直接对原始模型做量化:
| 方法 | SC | AQ | IQ | OC | MS | 平均 |
|---|---|---|---|---|---|---|
| 原始 FP | 0.9292 | 0.3126 | 0.4313 | 0.0952 | 0.9870 | 0.5511 |
| 早期量化 | 0.8995 | 0.2691 | 0.4688 | 0.1092 | 0.9363 | 0.5366 |
直接量化后,平均分数下降。值得注意的是不同指标的反应并不一致:成像质量(IQ)和整体一致性(OC)甚至略有提升,但主体一致性(SC)、美学质量(AQ)和运动平滑度(MS)下降明显。
这揭示了一个重要规律——量化误差对单帧指标影响小,对时序指标影响大。一帧中的微小扰动可能并不显眼,但经过多步去噪和多帧合成后,误差会在时间维度上累积放大。
6.3 蒸馏后量化
引入少步蒸馏后,步数成为主控制变量。平均分对比如下:
| 步数 | 种子 | 原始 FP | 同步 FP | 量化模型 |
|---|---|---|---|---|
| 4 步 | 42 | 0.6993 | 0.6799 | 0.6804 |
| 4 步 | 27182 | 0.6958 | 0.6791 | 0.6799 |
| 8 步 | 42 | 0.6993 | 0.6999 | 0.7004 |
| 8 步 | 27182 | 0.6958 | 0.6982 | 0.6999 |
| 20 步 | 42 | 0.6993 | 0.7058 | 0.7081 |
| 20 步 | 27182 | 0.6958 | 0.7044 | 0.7066 |
| 40 步 | 42 | 0.6993 | 0.7084 | 0.7077 |
趋势非常清晰:
- 4 步:量化模型已极度接近同步全精度模型(0.6804 vs 0.6799),但整体尚未追平原始 40 步基线;
- 8 步:量化模型开始反超原始全精度基线(0.7004 vs 0.6993),蒸馏带来的质量恢复已经足以补偿量化误差;
- 20 步:协同效应最强,量化模型达到 0.7081,明显超过原始基线 0.6993,且跨种子表现稳定;
- 40 步:量化模型与同步全精度基本持平(0.7077 vs 0.7084),继续增加步数的边际收益已经很小。
结论:20 步是当前设置下质量与效率的最佳平衡点。
6.4 最佳配置的逐项拆解
以 20 步、种子 27182 为例,看五个指标的明细:
| 方法 | SC | AQ | IQ | OC | MS | 平均 |
|---|---|---|---|---|---|---|
| 原始 FP | 0.9495 | 0.6474 | 0.6479 | 0.2524 | 0.9819 | 0.6958 |
| 同步 FP | 0.9597 | 0.6553 | 0.6828 | 0.2422 | 0.9821 | 0.7044 |
| 量化模型 | 0.9629 | 0.6571 | 0.6872 | 0.2434 | 0.9825 | 0.7066 |
量化模型在 SC、AQ、IQ、MS 四项上均超过原始全精度基线,OC 略低于原始基线但与同步全精度差距很小。优势不是靠单一指标的偶然波动,而是在多个维度上同时提升。
总结
综上,本文可以总结为以下几点:
- 少步蒸馏和低比特量化具有协同作用。
少步蒸馏先保证在减少去噪步数后,视频生成质量不会明显下降;低比特量化再进一步降低每一步的存储和计算成本。因此,两者结合后,可以同时降低“采样步数”和“单步计算开销”。
- 在降低推理成本的同时,生成质量能够保持甚至提升。
单独量化时,模型性能会低于原始全精度模型;加入少步蒸馏后,4步模型已经接近同等步数的全精度模型,而8步和20步设置甚至能够超过原始全精度基线。这说明少步蒸馏是量化模型恢复性能的重要条件。
- 方法较稳定,也具有实际部署价值。
量化模型与对应的少步全精度模型差距已经较小,而且不同随机种子下结果较一致。由于 Wan2.2 原本推理成本较高,该方法通过减少推理步数和降低单步成本,可以明显提升部署效率。
最后,原始 Wan2.2 模型在推理过程中需要较高的时间成本和硬件资源。通过减少去噪步骤数,并降低每一步的计算成本,所提出的流程为高质量视频生成模型的实际部署提供了一条可行路径。因此,本方法的价值不仅体现在基准测试得分上,也体现在工程应用与实际部署方面。
本系列将持续分享各赛道创新方案,解析其核心思路,敬请关注GCC-HiFloat社区!